开源项目Hugging Face

ZONOS3-Mini 开放轻量语音克隆模型
Zyphra 在 11 月 12 日公开的社区文章中介绍 ZONOS3-Mini,面向多语言语音合成、零样本声音克隆和精细发声控制。模型总参数约八亿,每次激活约一亿,文章称覆盖 43 种语言。
阅读全文查看来源为 Hugging Face 的资讯与动态,保留原文入口和发布时间。
Zyphra 在 11 月 12 日公开的社区文章中介绍 ZONOS3-Mini,面向多语言语音合成、零样本声音克隆和精细发声控制。模型总参数约八亿,每次激活约一亿,文章称覆盖 43 种语言。
阅读全文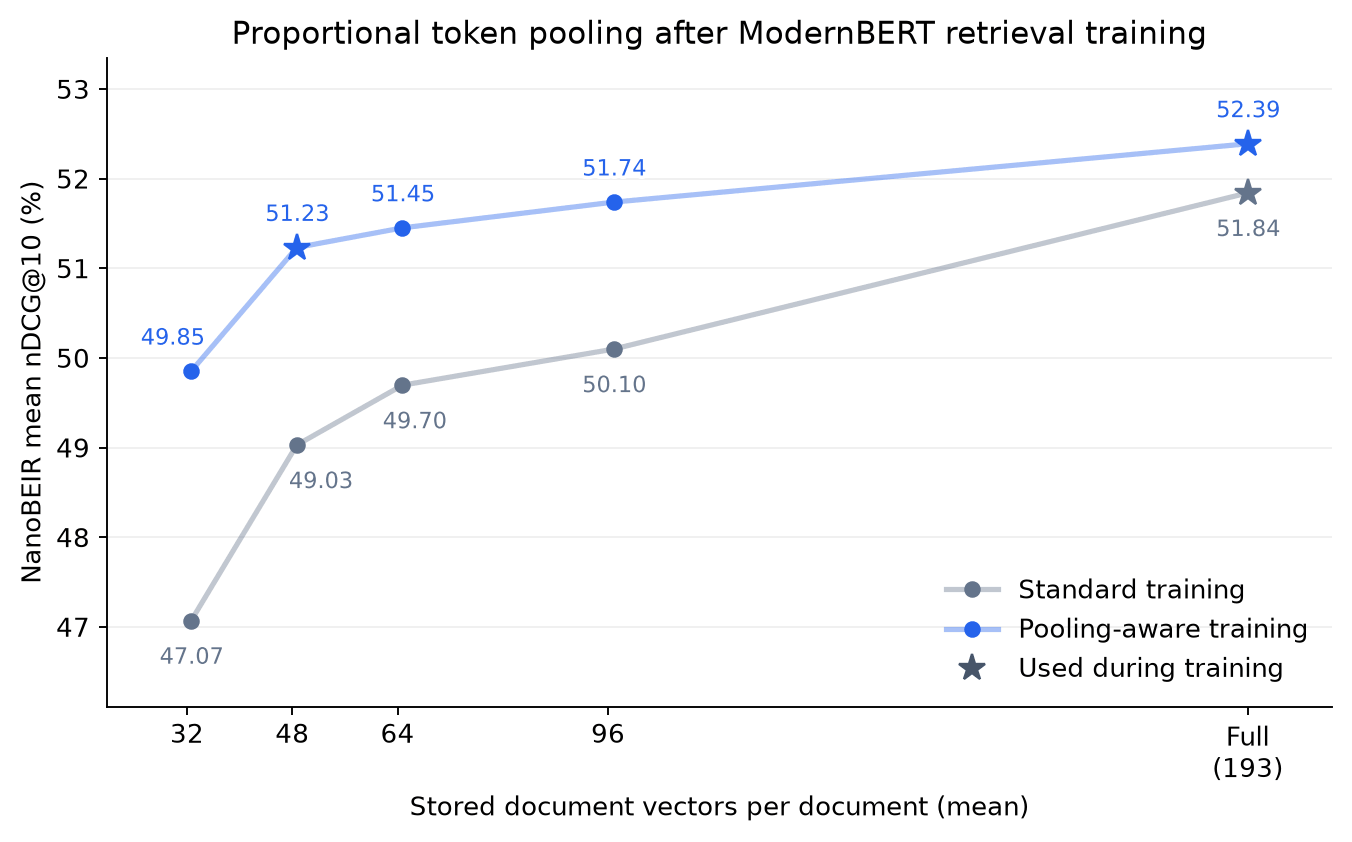
在减少文档向量数量时一同训练检索器,降低压缩带来的信息损失。
阅读全文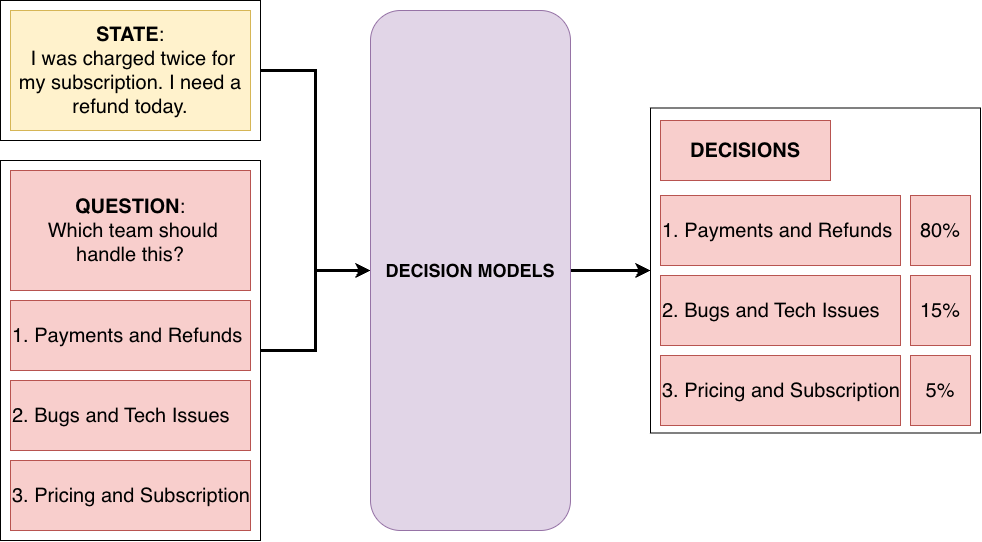
面向路由、分流和分类任务,在预定义选项上作选择,减少逐字生成的环节。
阅读全文
组织管理员可从 Google Cloud Marketplace 建立关联,统一管理部分 Hub 用量账单。
阅读全文共 34 篇
Zyphra 在 11 月 12 日公开的社区文章中介绍 ZONOS3-Mini,面向多语言语音合成、零样本声音克隆和精细发声控制。模型总参数约八亿,每次激活约一亿,文章称覆盖 43 种语言。
在减少文档向量数量时一同训练检索器,降低压缩带来的信息损失。
面向路由、分流和分类任务,在预定义选项上作选择,减少逐字生成的环节。
组织管理员可从 Google Cloud Marketplace 建立关联,统一管理部分 Hub 用量账单。
Open ASR Leaderboard 新增埃及英语和尼日利亚英语测试,便于按口音对比转写表现。
Ripple-65B Preview 提供开放权重及百万 token 上下文支持。
AtomicChat 在 Hugging Face 发布基于 DeepSeek-V4.1-Flash-1017 的社区 GGUF 衍生版本,组合 GSQ-RCO 量化和行为调整,并公开各个量化档位的测试记录。这是社区维护的版本,并非 DeepSeek 官方发布。
OBLITERATUS 公布了基于 DeepSeek-V4.1-Flash-1017 的行为调整版本,提供 BF16 权重和评测方法。这一社区版本改变了模型的拒答行为,不是 DeepSeek 官方更新。
AtomicChat 在 Hugging Face 发布基于 LiquidAI/LFM3-1.7B 的社区 GGUF 衍生版本,并附带行为变化和能力测试记录。它不是 Liquid AI 官方发行,仍需遵循基础模型的 LFM Open License v1.0。
Efficient-Large-Model 团队开放 Open-H3-Regenerate-2K,把低分辨率视频草稿重新生成为高分辨率画面。项目基于 MiniMax H3,提供三步细化流程,项目页列出最高 4K 的输出路径。
CCORE 发布 Qwen3.5-4B-3D-Coder 预览版,针对交互式 Three.js 场景和代码生成进行独立微调。项目提供 FP16、Q4_K_M 与 Q8_0 权重,还公开了包含 4146 个场景样例的训练数据集。
社区维护者 abenzerps 发布 Qwen-Image-2.1 量化资源,提供 GGUF、Safetensors 与 MLX 等格式,用于不同硬件上的本地图片生成。模型卡列出配套文本编码器、VAE 与 ComfyUI 文件目录要求。
商汤公开的 SenseNova-Loop-9B-Preview 支持文字和图像输入,面向长上下文、文档理解、编程及工具交互。它在解码器中重复执行一段共享权重的层,以较少的参数副本增加计算深度。
Audio8-TTS-Realistic-Air 基于 0.6B 级架构,支持文本转语音和零样本声音克隆。模型卡列出 23 种支持语言,并提供交互试玩入口、模型权重和 44.1kHz 音频编解码器。
小米研究团队公开 Xiaomi-OCR-0,面向文档解析和围绕文字的视觉理解。模型基于 Qwen3.5-0.8B-Base,官方模型卡介绍了约 1.7 亿条训练样本及渐进式训练流程。
Liquid AI 的 d1-2B 面向路由、分类、文档提取、审核和重排序等判断任务。它接收文字、图片或视频,通过一次前向计算返回结果,不像聊天模型那样逐个生成回答 token。
Sperid Labs 的 Idol 可以把一张物体图片转换为 3D Gaussian Splat,先去除背景、确定物体范围,再生成可由常见查看器打开的 PLY 文件。作者报告可输出超过一百万个高斯单元。
LFM3-Audio-2B 接收文字或音频,能够输出文字、语音或两者交织的回答,面向笔记本和边缘设备。模型采用自研音频编码器及 LiquidCodec,并提供转写和语音合成示例。
Pika H3 Flex 用六步采样生成视频和同步音频,并通过参考素材及提示控制镜头。公开模型支持本地 480p、768p 原生输出,托管 API 则提供更高分辨率和额外制作功能。
DiffuSpace 的 Clover-35B-A3B-Preview 基于 Qwen3.6 架构,结合块扩散生成与混合专家机制,总参数约 35B,每 token 激活约 3B 参数,支持 128K 上下文。
Mistral 在官方模型库公开 Large 4,一款万亿总参数规模的原生多模态混合专家模型。官方把指令跟随、推理、编程和智能体流程整合进同一组权重,并提供 API 与量化版本。
Liquid AI 的 LFM3-VL-2B 接收文字、图像与视频,面向本地文档阅读、图表理解、屏幕识别和物体定位。模型把 LFM3 语言部分与新的自研视觉编码器结合。
LFM3-Omni-2B 是 Liquid AI 的端到端全模态模型,可以理解文字、图像、视频和音频,并用文字或语音回答。其目标是在端侧把原本分开的识别、视觉理解、语言和语音合成组件合并。
英伟达公开 Nemotron 3.5 Transcribe,支持 40 种语言的离线转写,可处理最长一小时录音,并提供翻译、说话人归属、时间戳和音频问答等功能。权重包含多种精度版本。
Zyphra 在 11 月 12 日公开的社区文章中介绍 ZONOS3-Mini,面向多语言语音合成、零样本声音克隆和精细发声控制。模型总参数约八亿,每次激活约一亿,文章称覆盖 43 种语言。