NEWS DESK新闻资讯
人工智能日刊 · 第 20 页
最近发布的产品动态、研究进展与行业消息。
订阅
切换主题
- 研究arXiv
Hx2Dx 让模型先问诊再诊断
千例交互式病例测试显示,主动获取信息会暴露静态答题未覆盖的短板。 Hx2Dx ARENA 预印本构建了包含 1000 个临床病例的交互评测。模型需要从初始表现出发,通过询问病史、体格检查和申请检验逐步获取信息。 这些病例来自《新英格兰医学杂志》的案例材料。团队比较多个开放及闭源模型后发现,交互环境中的诊断准确率都低于一次获得完整病历的静态环境。
- 视频arXiv
LASER 通过预测下一步变化读懂视频状态
模型先判断哪些属性值得检查,再用后续画面校验物体状态记录。 LASER 预印本提出一种视频物体状态读取方法。面对连续画面和指定物体,系统先设想下一步可能发生的变化,再提出针对当前画面的视觉问题。 得到属性记录后,系统用后续帧的独立观察检验预测,逐步修正状态描述。文本形式的观察技能可以依据训练样本的错误改进,模型参数在适配和推理中保持冻结。
- 机器人GitHub
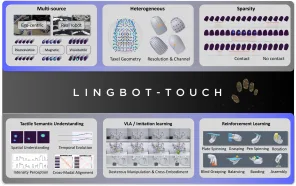
LingBot-Touch 统一三类机器人触觉信号
蚂蚁灵波开放推理代码,让磁、压阻和视觉触觉进入共享表征。 蚂蚁灵波发布 LingBot-Touch 触觉表征模型,尝试把磁触觉、压阻式和视觉触觉传感器的不同信号转换为共享表示。 模型采用 JEPA 式潜在表征预测和共享 Transformer,可把触觉特征接入机器人动作策略。官方仓库提供冻结编码器及特征提取工具,模型文件另在 Hugging Face 和 ModelScope 托管。
- 研究arXiv
百万条盲评显示用户对 AI 的要求在提高
研究固定版本模型的历史对比,发现“两个答案都不好”的投票比例持续上升。 一项新预印本分析了 Chatbot Arena 的 126 万余条盲评投票,研究用户评价标准是否会随时间变化。样本覆盖 2023 年 5 月至 2024 年 8 月,并重点比较版本固定的模型。 作者发现,即使是同一对未改变的模型,“两个答案都不好”的投票比例也随月份上升,而相对强弱排序大体稳定。研究还控制了投票者、提示词和语言等因素。
- 开发工具GitHub
llm-gemini 0.36 接入 Gemini 4 Carbon
Simon Willison 的命令行插件跟进新模型,延续 LLM 工具的本地调用方式。 Simon Willison 发布 llm-gemini 0.36,让 LLM 命令行工具能够调用新开放的 Gemini 4 Carbon。项目在公开仓库提供版本记录与安装入口。 开发者可以沿用 LLM 及插件的调用方式,在命令行组织提示词、选择模型和处理输出。作者另发布了自己的模型使用记录,展示不同推理配置下的生成结果。
- 研究arXiv
LM-SimBench 为大模型训练模拟建立基准
用真实集群采样的数据比较模拟器,辅助选择分布式训练配置。 LM-SimBench 预印本提供统一的训练模拟评估框架与数据集,目标是在真正启动昂贵的分布式训练前,更可靠地比较并行化方案。 团队在昇腾 NPU 集群上测量了十类稠密及 MoE 模型家族的 23 组模型设置,得到 348 个可行配置,覆盖多种并行维度和激活重计算选择。
- 研究arXiv
MaLoRA 尝试更稳地合并多个微调适配器
研究从分类间隔出发,分析保留旧能力、学习新任务与适配器混合的关系。 MaLoRA 预印本分析了 LoRA 微调中两个常见现象,即旧能力的保留,以及分别训练的适配器能否合并使用。 研究者在带有特定假设的多分类模型中,用分类间隔描述预训练任务与新任务的权衡,并据此推导适配器混合系数,提出无需额外训练的合并规则。
- 研究TNG Technology
研究为冻结的 MoE 模型追加领域专家
团队尝试给 Qwen 模型补充 Rust、Haskell 能力,只训练新增专家和路由权重。 TNG Technology 团队公布一种扩展 MoE 模型的实验方法,在冻结原模型的情况下追加领域专家,测试能否补足特定编程语言能力。 实验以 Qwen3.5-35B-A3B-Base 为基础,新增面向 Rust 和 Haskell 的专家,同时训练少量路由参数,让模型选择使用原有能力或新增专家。
- 视频Figma AI
Figma 团队用百项任务评测 AI 动画制作
MotionGraphicsBench 从已有 SVG 出发,检查动作、轨迹和时序是否符合要求。 Figma 与斯坦福研究者介绍 MotionGraphicsBench,用 100 个任务评测模型如何为已有矢量图制作动画。每项任务提供静态 SVG 和动画修改要求。 团队评估了 32 个专有及开放权重模型,只有四个在最高可用推理配置下取得超过 50% 的首次通过率。常见问题包括姿态不符、运动轨迹错误及多个事件缺乏协调。
- 商业TechCrunch
Odessia 宣布被 OpenAI 收购并停止服务
旅行智能体官网公布过渡安排,原有用户可联系支持处理已有行程。 旅行智能体 Odessia 在官网宣布已被 OpenAI 收购,并表示原有服务在过渡期间停止提供。网站保留了处理已有预订和行程的支持联系方式。 创始人 Francis Davidson 同时宣布加入 OpenAI。交易金额尚未披露,OpenAI 当时也未公布对应旅行产品的具体推出计划。
- 商业Oura
Oura 拟以 6.25 亿美元收购 Counsel Health
智能戒指公司计划把持续健康数据与医生监督的 AI 诊疗服务连接起来。 Oura 与 Counsel Health 于 11 月 10 日宣布签署收购协议,交易金额为 6.25 亿美元现金。双方此前已围绕 Oura 用户的在线医疗需求开展合作。 Counsel Health 结合医疗 AI 与执业医生提供线上服务。Oura 希望把戒指记录的连续生理数据与问诊过程连接起来,使用户能从健康变化提示进一步取得个性化照护。
- 研究arXiv
PARLEY 用协作谜题测试智能体沟通能力
两个模型掌握不同信息,需要持续反馈和校验才能一起完成任务。 PARLEY 预印本提供四类不对称协作谜题,评估大模型智能体如何交换信息、协调动作及理解对方视角。研究使用 GPT-4o 智能体配对完成测试。 在 400 段对话中,任务平均成功率为 60.5%,不同任务的结果相差较大。团队把失败归为感知、适应和协调等类型,其中反复忽略外部反馈是一个突出问题。
- 开发工具GitHub
Qwen Code 1.0 预览版融合 Qoder 能力
提供三大桌面系统的原生安装包,支持恢复会话和非交互式执行。 Qwen Code 于 11 月 11 日发布 v1.0.0-preview。项目把 Qoder 与 Qwen Code 的智能体能力整合,用于代码理解、实现、调试和测试。 这一版本提供 macOS、Linux 和 Windows 的原生安装包,无需另外安装 Node.js。用户可以使用千问或 Qoder 账号,也可配置其他模型提供方与兼容接口。
- 研究arXiv
ReTrace 把智能体操作记录转成可复用流程
研究用规则和代码接管重复步骤,在部分任务中降低调用成本与执行时间。 11 月 10 日提交的 ReTrace 预印本提出,把标准操作流程和少量智能体运行记录编译成可执行工作流。重复执行时,由代码依据规则选择下一步。 方法会提取每次工具调用背后的条件,合并成规则文档,再生成适合不同编排平台的执行实现。在团队测试的 79 个生产流程中,完成率为 93.8%,对照智能体为 96.8%,单任务成本降低 24%。
- 安全arXiv
Sable 为量化模型推理结果生成可验证证明
研究尝试证明给定输出确实来自指定模型与输入,但生成证明仍有明显开销。 Sable 预印本提出一种推理证明系统,用来验证承诺过的整数化 Transformer 是否依据给定提示生成了指定 Token 序列。系统将舍入和采样等步骤也纳入确定性计算。 作者在单张 RTX PRO 6000 Blackwell 上测试 Qwen2.5-32B,4096 Token 的证明生成耗时为 92.5 秒。实验还覆盖其他 Qwen 模型。
- 音乐Spotify
Spotify AI DJ 新增声音和少说话选项
英语和西班牙语增加多种声音,用户可关闭歌曲之间的大部分解说。 Spotify 于 11 月 10 日开始更新 AI DJ,向已支持这项功能的市场提供更多声音和解说控制。新选择面向 Premium 用户逐步推出。 这次新增七种英语声音和两种西班牙语声音,涵盖不同口音与表达方式。用户还可以关闭歌曲间的解说,让音乐更连续地播放。
- 研究arXiv
TAME-O 让多模态助手持续识别用户新概念
研究尝试在长对话中吸收新物品与实体,同时减少和旧记忆混淆。 TAME-O 预印本把多模态助手的个性化识别扩展到开放集合场景,研究用户在持续交互中引入新物品、新实体时,助手如何逐步掌握这些概念。 方法采用无需额外训练的概念协调技能,在较长上下文中检查新旧概念关系,更新已知对象的描述,并尽量减少不同对象相互混淆。
- 资讯arXiv
SPU 基准测试 AI 对湿实验结果的预测
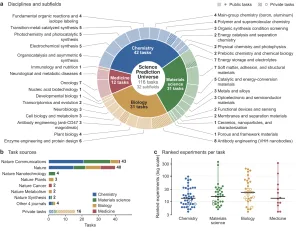
SPU 用 100 项公开任务与 16 项私有任务,测试智能体对真实湿实验结果的排序预测。论文 11 月 11 日提交,本篇为近期研究补录。 UniPat AI 等研究者提出 Science Prediction Universe(SPU),用真实湿实验的测量结果评估 AI 智能体的预测。论文于 2026 年 11 月 11 日提交 arXiv;本篇为近期研究补录。 SPU 包含 100 项公开任务和 16 项来自未发表实验的私有任务,覆盖化学、材料、生物与医学。智能体根据实验条件给候选项排序,评分程序将排序与隐藏的真实测量结果比较。
- 研究arXiv
Agent-R² 用真实文件训练办公智能体
研究从公开材料构造约 4000 项办公任务,把多种格式的附件和可核查的交付要求配对。 11 月 5 日提交的 Agent-R² 预印本提出了一套办公智能体训练数据方法。研究人员从真实职业任务和公开文件抽取流程,组合多种格式的附件,再为每项任务制定可检查的交付标准。 团队用约 4000 项任务训练 4B 模型,报告其 GDPval 得分为 51.0%、OfficeQA 为 14.8%。两个数字来自作者设置的评测,说明的是指定办公任务中的表现。
- 研究arXiv
Scientist World 将论文变成可运行的实验
研究团队先发布 1000 个可执行环境,供科研智能体复现论文基线并尝试改进。 一篇 11 月 5 日提交的预印本介绍了 Scientist World。研究团队从论文提取研究问题、复现原方法,并把任务和评测放进可执行环境。首批公开 1000 个环境,智能体的结果可与论文复现基线比较。 团队称,该项目保留了约 6400 小时的研究过程记录,包括实验、失败和有效尝试。作者报告的改进比例只对应这批可运行任务与其评测标准。
- 应用Airbnb
Airbnb 用微调小模型做内容分类
其工程团队报告,Gemma4-E2B 在本次分类测试中达到 0.902 F1,中位延迟约 35 毫秒。 Airbnb 工程团队发布内容分类基准,对比了不同模型的准确率、延迟和服务成本。团队用数十万条领域样本微调 Gemma4-E2B,在该测试中把 F1 从 0.563 提升到 0.902,中位延迟约 35 毫秒。 Airbnb 还指出,自托管成本的优势取决于请求量和 GPU 利用率。团队在这项特定分类任务中获得的结果,不能直接外推到其他类型的内容审核或通用推理。
- 商业Amazon
亚马逊开始测试用短信和 Alexa 购物
首批向部分美国用户开放,可通过短信找商品、加购物车、查订单和设置降价提醒。 亚马逊 11 月 6 日宣布,开始向部分美国用户开放 Alexa 购物助手的短信入口。收到邀请的用户绑定手机号后,可以通过短信描述需求、发图找类似商品、查看订单或设置价格提醒。 购物助手还可以整理清单、比较商品、加入购物车和按用户指令完成购买。亚马逊计划在之后几周扩大开放范围,未收到邀请的用户可以登记等待通知。
- 研究Anthropic
Anthropic 拆解智能体如何跨会话记忆
团队测试让 Claude 在空闲时复查旧日志、纠错和更新知识库,以改善后续任务。 Anthropic 在 11 月 6 日发布研究文章,将智能体的记忆拆分为会话日志、记忆笔记、整理后的知识表征以及注入模型的上下文。研究团队还让智能体在会话之间回顾日志、检查旧笔记中的错误,并把经过验证的信息写入知识库。 团队在持续学习基准中测试了带记忆和不带记忆的 Claude,也用游戏任务和企业文档展示何时该保存或修正信息。这些属于研究实验,文章没有宣布面向所有 Claude 用户上线同样的功能。
- 安全TechCrunch
安全研究人员发现大量 Artex 控制台暴露
TechCrunch 援引 Censys 的发现报道,部分 AI 渗透测试工具控制台对公网开放。 TechCrunch 11 月 6 日援引安全研究机构 Censys 的发现称,数百个托管 Artex 的控制台可从公网访问。Artex 用于自动化渗透测试,一些暴露的部署未为控制界面设置认证。 云安全联盟同日发布研究笔记,另行记录了被篡改的 Artex 容器镜像。镜像存在后门与控制台暴露是两个问题,相关报告没有把所有公网实例归为同一攻击活动。