NEWS DESK新闻资讯
人工智能日刊 · 第 17 页
最近发布的产品动态、研究进展与行业消息。
订阅
切换主题
- 安全OpenAI
Cogent 披露从漏洞排查到修复的智能体流程
OpenAI 11 月 10 日介绍 Cogent Security 的企业网络防御系统。它把资产、漏洞、身份和业务依赖组成上下文,再交给智能体调查风险、制定修复步骤,并检查处理是否有效。 Cogent 使用策略引擎在执行前核对工具调用,企业可以只授权调查、要求变更先审批,或允许在限定范围内自动修复。高风险操作还可以放到隔离环境中进行。 据案例披露,一家汽车行业客户的关键漏洞平均修复时间缩短 75%,另一家 IT 服务客户的漏洞分诊吞吐量提高至五倍。这是指定客户的企业自报效果,不能理解为系统无需授权就能自动修改任意生产环境。
- 研究arXiv
研究让科学智能体同时比较多种解释
11 月 10 日提交的 Contrastive Discovery 研究,要求科学智能体为同一个问题提出一组相互竞争的解释,再用实验结果更新判断,避免只知道一个猜想不成立,却无法继续寻找答案。 团队在六个领域比较两种方式:在相同证据下,对照解释方法为 73% 的相关候选找到具体替代解释;在相同实验预算下,用它指导搜索解决的问题数量增加 67%。 论文还邀请 38 位专家进行盲评,检查智能体选择的解释是否与人的判断一致。结果支持在研究流程中显式维护替代假设,但不代表生成的科学结论可以跳过实验验证。
- 音频DeepL
DeepL 发布 Aure,语音翻译跟随情绪和语调
DeepL 11 月 11 日公布语音 AI 模型 Aure,用于 DeepL Voice 的实时翻译。它不仅保留说话者的声音特征,还尝试持续跟随语速、强调方式和情绪变化。 此前方案主要从开场音频获取相对固定的声音样本。DeepL 称,Aure 会持续分析输入音频,并结合译文决定如何发声,让翻译后的句子反映说话过程中出现的表达变化。 团队将噪声、回声以及跨语言保持身份和韵律列为技术难点。相关自然度提升来自厂商的产品介绍;具体语言覆盖和使用条件仍需按 DeepL Voice 的产品说明确认。
- 音频arXiv
Earlybird 用 2900 万参数尝试提前识别词语
研究者 11 月 10 日提交 Earlybird 流式语音识别模型,参数量为 2900 万。它在单词尚未完全说完时预测当前词,并给出后续词语的猜测和置信度,面向更低延迟的语音助手。 在干净有声读物测试中,模型正确识别单词的中位时刻比说话者结束该词早约 90 毫秒;69% 的单词可在说完前被正确预测。团队还在演讲、财报电话会议等六组数据上比较输出时机。 预测不等于已听到完整内容,错误猜测仍可能发生。论文报告了未说完词语的置信度校准结果;实际应用需要决定何时等待更多音频,不能把提前预测直接当成确认指令。
- 研究arXiv
EngineAgent 让编程智能体适配手机推理引擎
11 月 10 日提交的 EngineAgent 研究,把手机端新模型适配拆成跨层修改和设备验证流程。系统先整理推理引擎、算子与硬件后端之间的依赖,再让构建智能体修改实现、审查智能体检查遗漏。 团队在三个移动模型、四种引擎与后端组合构成的十二项任务中测试 CPU、GPU 和 NPU。论文报告,两个底层模型分别搭配该系统时,端到端成功率均为 75%,最强对照编程智能体为 33.3%。 成功标准不仅是编译通过,还要求在设备上运行,并使输出的 logits 与参考实现一致。该工作针对特定适配任务进行评测,不意味着可以自动支持任意手机和模型。
- 应用OpenAI
澳大利亚律所披露 AI 使用率与工作流实践
OpenAI 11 月 12 日发布澳大利亚律所 Gilbert + Tobin 首席执行官 Sam Nickless 的访谈。律所称,在获配 ChatGPT 使用权限的人群中,活跃使用比例达到 87%;这一数字不是整个法律行业的采用率。 该所从限制输入客户机密信息的试验开始,再引入 ChatGPT Enterprise、ChatGPT Work 和 Codex,逐步处理多步骤流程。其管控措施包括澳大利亚数据驻留、角色权限和管理设置。 Nickless 举例称,他利用工作流处理 120 名合伙人的年度评审材料,包括更新文件、生成 PDF 和打包,使用成本约 62 美元。他强调员工仍需界定任务、检查输出并负责最终结果;案例不是让模型代替律师作法律判断。
- 应用Google
Gmail 向更多 Workspace 用户开放摘要与写作辅助
谷歌宣布将 Gmail 的部分 Gemini 功能扩展到更多年满 18 岁的 Workspace 用户。新开放的能力包括长邮件对话的 AI Overview 摘要,以及根据简单要求生成或润色邮件的非个性化 Help me write。 更新从 11 月 10 日开始分批推送,功能可见性最长可能需要十五天。符合条件的用户还需启用 Gmail 智能功能;管理员可以关闭 Gemini 功能,用户也可以在设置中停用。 这次扩展涉及指定的摘要和写作能力,并不表示所有付费 Gemini 功能都无条件开放。学校或工作账号能否实际使用,仍受年龄、管理员设置和分批推送进度影响。
- 研究Google
谷歌研究用可穿戴数据模拟健康习惯变化
谷歌研究团队 11 月 11 日介绍一套可穿戴设备健康研究框架,将静息心率、步数、睡眠和活动量转成可随生活习惯变化的健康年龄指标,并可结合常规血液检查观察心血管、肾脏与代谢状态。 配套 SensorWM 世界模型使用约十万名已同意参与的 Fitbit 用户数据训练,根据最近两周记录,模拟改变步行、睡眠和运动习惯后,未来十二周的生理指标走势。语言模型再把模拟结果转成可执行的习惯建议。 研究基于回顾性数据及离线评估,尚不是临床诊断工具,也未证明某个用户照做就会获得指定健康改善。团队计划通过后续前瞻性试验检验实际效果。
- 前沿xAI
Grok Bot 1.0 更新支持会议与 Teams 协作
Grok Bot 的官方更新日志显示,11 月 11 日发布的 1.0.1 包含 1.0.0 更新,新增加入 Google Meet、Zoom 和 Microsoft Teams 会议的能力,并扩展团队协作功能。会议能力面向 Team、Enterprise 和 Ultra 方案。 用户可以提供会议链接,让 Bot 在会议聊天中回答问题,并在会后发送摘要。团队 Bot 接入 Microsoft Teams 需要相应管理员启用和批准;共享连接器与 Bot 分享范围也受团队管理设置控制。 团队成员教给 Bot 的新知识会进入待审核列表,由所有者或管理者批准。虽然介绍文章的页面日期标为 11 月 2 日,本次报道依据 11 月 11 日的具体版本日志,避免把两个时间混为一谈。
- 安全Ars Technica
研究者发现 Grok Build 共享应用存在数据暴露风险
安全研究机构 Claroc 11 月 10 日公布对 Grok Build 已发布应用的调查,称在其检查的 37571 个仍在线应用中,35578 个无需登录即可打开,其中部分包含内部业务或个人资料。 公开应用多数是游戏、展示页和计算器,不能把所有可访问应用都当成敏感数据泄露。研究者估计约十分之一含敏感材料,并用自己创建、填入虚构数据的应用检查默认访问设置。 研究者称已向平台报告,相关媒体随后观察到部分链接被移除。事件提醒使用者区分“知道链接就能访问”和真正的身份认证;本报道不公布受影响用户、个人资料或可被继续访问的应用地址。
- 开发工具GitHub
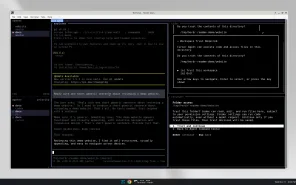
Herdr 社区技能让后台编程智能体可查看、可介入
Prompt Case 分享了社区项目 herdr-grok-bot:让 Grok Bot 启动本地交互式编程智能体时,经由 Herdr 统一管理。用户可以在一个终端界面中查看各个智能体的状态、工作区和对话,并在需要时介入。 仓库提供主技能、安装说明和使用文档,采用 MIT 许可。它是操作约定,不是底层拦截器,作者也明确说明无法保证 Bot 在每次执行中都严格遵循。 这是社区制作的技能,并非 Herdr 或 xAI 官方产品。仓库同时区分真实桌面截图与 AI 生成示意图;本文采用其标明为真实界面的截图,不将示意画面当作实际软件界面。
- 视频OpenAI
JioStar 披露多语言视频搜索助手的落地经验
OpenAI 11 月 11 日发布 JioStar 首席架构师 Vijay Seshadri 的访谈,介绍 JioHotstar 如何用自然语言帮助观众寻找影视节目、板球历史片段和比赛统计。受访者称,小团队约八周完成支持十五种以上语言的体验。 据访谈,超过六成该体验的用户选择语音输入。团队围绕准确率、响应延迟和调用成本做取舍,并先规定系统不应回答哪些问题,再加入领域专家整理的评估案例。 团队还使用模型扩展测试题,并设置另一个模型核查答案。访谈中的五亿用户是 JioStar 平台覆盖规模,不代表五亿人都在使用这款 AI 助手;文中是企业公开的落地案例,也不是今天首次上线产品的公告。
- 前沿极客公园
联想发布词元工厂品牌,首个项目拟落地张家口
联想 11 月 10 日在张家口发布“万全混合词元工厂”品牌,并签约推进当地母本工厂。方案连接 AI 基础设施、模型调度与企业智能体应用,强调混合部署和按任务调配算力。 根据发布会披露的初期规划,项目拟建设约 100MW 智算中心和 1.5 万 P 异构算力集群,目标词元年产量超过 2000 万亿。这些是项目规划指标,不能视为已经投产后的实测产能。 联想还介绍了与湖南广电合作的内容制作场景,计划服务文本、图片、视频与渲染任务。工厂将从张家口起步,再按不同地区的资源和产业条件推进布局。
- 开源GitHub
MACaQ 开源量化工具支持文本与多模态模型
MACaQ 开源项目提供模型校准量化工具,面向本地推理和多模态部署。仓库由 huawei-csl 维护,支持与 llama.cpp、vLLM、Diffusers 和 PyTorch 等后端配合使用。 项目说明展示了文本模型转为低比特 GGUF,以及图像、视频、音频生成模型的量化路径。团队称,一项 1220 亿参数模型量化测试使用约 32.5GB 设备显存,耗时约 64 分钟。 项目为不同模型和推理后端提供独立环境与格式说明。量化速度和质量仍受模型、显存及目标精度影响,上述性能数字来自维护方测试。
- 研究arXiv
MMDM 用五千多道题测试 AI 决策能力
MMDM 研究于 11 月 10 日提交,为直接输出选项概率的决策模型建立测试。基准包含 5448 道题、十六类任务,覆盖工具选择、状态跟踪、偏好判断和评分等场景。 题目的候选项从两个扩展到 1024 个,输入最长接近 6.5 万 Token。团队评估 28 个决策模型,发现常识题表现较好并不代表能同时处理选项之间的依赖、约束条件或多选任务。 在论文设置下,所有模型中最好的严格多选准确率为 36.81%。研究希望让评测更贴近长上下文和复杂选择,而不是宣称某个模型在所有业务决策中都更可靠。
- 研究arXiv
NumPrint 用数字序列辨认模型身份
研究者 11 月 10 日提交 NumPrint,探索模型能否通过一串数字暴露自身特征。基准收集 51 个模型的 5036 份回答,提示模型一次给出 294 个指定范围内的整数。 团队结合浅层网络与因果 Transformer,学习数字选择偏好和序列行为。在已知的 51 类模型封闭测试中,一份回答的识别准确率达到 92.72%;增加到两份和四份后,结果继续提高。 这是受控候选集合内的身份分类实验,不能据此保证识别任意新模型、被修改的服务或路由混合模型。它提供了一种可观察的辅助信号,而不是通用“验真神器”。
- 机器人NVIDIA
英伟达公布 GR00T 2,机器人可从人类示范学技能
英伟达公布 GR00T 2 世界动作模型及技术报告,把未来视频和机器人动作放在同一模型中预测。研究演示了从人类视频、手持夹爪或可穿戴设备获得的技能向机器人迁移。 在官方的 50 项未见任务测试中,零样本成功率为 40%;每项任务提供五次示范,并在单张 RTX 5090 上微调约半小时后,成功率达到 95%。这些数字对应特定机器人和评测条件,不代表任意家庭任务都能达到同样效果。 配套 GR00T 2 Turbo 面向机载运行,官方报告其在宇树 G1 的 Jetson Thor 上单次预测耗时为 124 毫秒。
- 前沿OpenAI
OpenAI 在美国五城举办照护者 AI 培训
OpenAI Academy 11 月 10 日联合 Caregiver Action Network、阿尔茨海默病协会和美国糖尿病协会,在奥克兰、坦帕、匹兹堡、亚特兰大和底特律举办免费的线下 ChatGPT 实操培训,面向家庭照护者及社区健康组织。 培训重点是整理照护日程和清单、将可信教育资料改写成易读说明、寻找社区资源,以及准备互助小组讨论材料。活动不要求编程背景,由培训人员现场协助。 课程同时覆盖隐私保护和工具局限,强调医疗等重要判断仍需咨询专业人员。该活动属于 AI 使用技能教育,不是推出诊断或治疗服务。
- 研究OpenAI
OpenAI 报告:学生用 AI 多,使用指导少
OpenAI 11 月 10 日发布教育合作经验报告,引用 ThinkYoung 调查称,受访学生中有 79% 使用 AI 完成作业或学习任务,但只有 47% 表示有人教过他们如何使用。这些数字来自该调查样本,不能直接视为全球学生比例。 报告整理了爱沙尼亚、希腊、斯洛伐克等地合作中的经验,重点包括教师培训、本地课程适配、明确使用规范和持续评估。OpenAI 主张先明确教学目标,再决定工具如何进入课堂。 教师报告的节省时间和使用率被列为早期信号。报告同时承认,AI 对独立思考、知识掌握和长期记忆的影响还需要更长时间的研究,现有合作并不能证明一种适用于所有学校的教学模式。
- 商业OpenAI
OpenAI 与 Upwork 研究 AI 如何改变接单需求
OpenAI 与 Upwork 11 月 10 日公布研究:随着 AI 被更多使用,自由职业项目正在组合新的技能要求;AI 相关项目往往拥有更大的固定报价预算,也涉及更多工时。研究没有把预算增长直接等同于时薪上升。 团队将 ChatGPT 中的工作活动与 Upwork 岗位需求对照。在分析的 63 个工作类别中,43 个呈现出一种关系:ChatGPT 使用更常见的活动,在 Upwork 上的需求份额下降;其余 20 个类别并不符合这一方向。 报告还发现,2023 年初至 2025 年末,AI 相关项目的任务组合多样性增加约 45%。作者将其解释为工作内容和项目范围发生变化的信号,而不是 AI 已造成全面岗位替代的因果证明。
- 研究arXiv
PASE 把智能体技能拆成可修改的程序
11 月 10 日提交的 PASE 研究,为智能体技能关联可执行程序,把操作流程与自然语言说明分开维护。任务失败后,系统可以针对程序片段打补丁,而不必反复重写整份技能文档。 作者在不同模型和基准上比较这种方式,报告其相对所测基线获得超过 2.8% 的改进,并在技能持续演化中呈现更稳定的效果。论文强调,程序化表达便于对具体步骤进行定向更新。 这项研究不需要修改基础模型参数。作者在论文中表示将通过 GitHub 发布代码和数据,因此稿件不把“计划公开”写成已经提供完整可下载工具。
- 应用GitHub
PeepNote 把 AI 回答、Markdown 与截图集中保存
PeepNote 是一款本地优先桌面笔记应用,把值得保留的 AI 回答、Markdown 笔记和截图放到同一个资料库,支持通过快捷键保存、检索和再次调用。 项目展示了快捷列表、截图保存,以及将多份相关记录整理成一份笔记的工作方式。应用数据保存在本机,可选 AI 摘要需要用户自行配置服务与 API Key。 用户可以将资料保存在本机,也可以自行选择摘要服务。本地存储与外部 API 调用是两条不同的数据路径,启用摘要后并非所有处理都在离线环境完成。
- 开源GitHub
Prefixwise 帮开发者定位提示词缓存浪费
开源项目 Prefixwise 针对编程智能体的提示词缓存开销,记录请求之间最先发生变化的位置,帮助区分正常缓存失效和可以避免的重复消耗。仓库提供代理与日志分析两种接入方式。 工具可以放在智能体与模型接口之间,也可以导入本地已有日志。维护者展示了工具列表顺序变化导致缓存前缀不一致的案例,并提供按会话查看原因、费用和候选修正的报告。 报告会把成本、缓存命中和上下文变化放在一起,方便开发者检查工具列表或提示词前缀的改动。它关注可追溯的缓存浪费,不承诺固定比例的费用节省。
- 应用OpenAI
新航披露 AI 客服与航班推荐应用进展
OpenAI 11 月 10 日公布新加坡航空案例:新航把模型用于 Kris 客服机器人、自然语言航班推荐和内部员工平台 Jarvis。案例介绍的是已有部署的进展,并非当天才首次采用 AI。 新航在案例中报告,升级后的 Kris 客服满意度评分约为原来的两倍,使用 AI 辅助工具的客服人员平均处理时间缩短约 10%,航班推荐工具的月度用户量在过去一年约增至三倍。 公司还把模型用于软件开发和员工工作流程。这些效果数字来自企业自身统计,具体业务、评估周期与用户群体不同,不能据此推算所有航空客服都能获得相同提升。